Trong bối cảnh trao đổi thương mại, du học, du lịch và văn hóa giải trí giữa Việt Nam và Nhật Bản ngày càng sôi động năm 2026, nhu cầu dịch tiếng Nhật phiên âm (thường gọi là dịch sang Romaji hoặc chuyển đổi Kanji/Kana sang chữ La-tinh) đã vượt ra khỏi phạm vi đơn thuần là “đọc cho biết”. Nó trở thành một bước quan trọng trong quy trình địa phương hóa (localization), tối ưu hóa SEO cho website tiếng Nhật, xử lý dữ liệu lớn (Big Data) và huấn luyện mô hình AI đa ngôn ngữ. Bài viết này sẽ cung cấp cái nhìn sâu sắc, cập nhật nhất năm 2026 về định nghĩa, công cụ, kỹ thuật chuyên nghiệp, lỗi thường gặp và xu hướng tương lai của lĩnh vực này.
1. Dịch Tiếng Nhật Phiên Âm Là Gì? Phân Biệt Rõ Ràng Năm 2026
Trước khi đi vào chi tiết, năm 2026 chúng ta cần định nghĩa lại khái niệm này chính xác để tránh nhầm lẫn với “dịch nghĩa” hay “biên dịch song ngữ”.
Dịch tiếng Nhật phiên âm (Japanese Transliteration/Romanization) là quá trình chuyển đổi văn bản tiếng Nhật (viết bằng Kanji, Hiragana, Katakana) thành hệ thống chữ La-tinh (Romaji – ローマ字) dựa trên âm thanh của từ vựng, không dịch nghĩa từ vựng đó sang tiếng Việt hay tiếng Anh.
Ví dụ minh họa rõ ràng:
- Gốc (Kanji/Kana): 東京駅
- Phiên âm (Romaji – Hepburn): Tōkyō Eki
- Dịch nghĩa (Tiếng Việt): Ga Tokyo
- Dịch nghĩa (Tiếng Anh): Tokyo Station
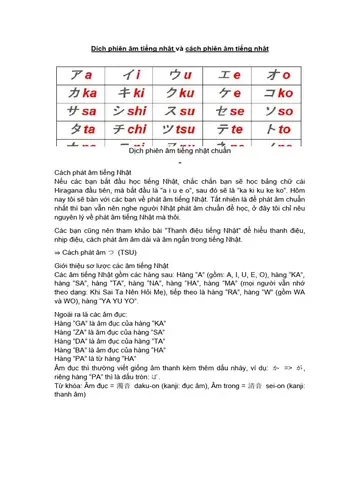
1.1. Ba Hệ Thống Phiên Âm Chuẩn Quốc Tế (Cập Nhật 2026)
Năm 2026, ba hệ thống chính vẫn được sử dụng song song tùy mục đích, nhưng Hepburn (Hepburn-shiki) vẫn là chuẩn mực vàng (de facto standard) cho quốc tế, du lịch, hộ chiếu và SEO.
| Hệ thống | Tên tiếng Nhật | Đặc điểm chính | Ứng dụng phổ biến năm 2026 |
|---|---|---|---|
| Hepburn (ヘボン式) | Hebon-shiki | Dựa trên phát âm tiếng Anh. Ghi long âm (ō, ū), âm n قبل p/b/m (m), sokuon (っ -> pp, tt…). | Hộ chiếu, biển báo đường bộ, tên địa danh, SEO quốc tế, từ điển, API Google/Map, thư viện Congress. |
| Nihon-shiki (日本式) | Nippon-shiki | Dựa trên cấu trúc Kana (kana 1-1). Ví dụ: si, ti, tu, hu, du, syo. | Ngôn ngữ học, nghiên cứu cấu trúc tiếng Nhật, một số hệ thống nhập liệu cũ (IME). |
| Kunrei-shiki (訓令式) | Kunrei-shiki | Sửa đổi từ Nihon-shiki để gần Hepburn hơn. Ví dụ: shi, chi, tsu, fu, ji, syo. | Giáo dục chính quy tại Nhật Bản (tiểu học), một số tài liệu chính phủ nội bộ. |
Lưu ý quan trọng 2026: Khi làm SEO website tiếng Nhật hoặc dữ liệu huấn luyện AI, bắt buộc tuân thủ Hepburn Modified (Hepburn có dấu thanh/long âm) hoặc Hepburn không dấu tùy cấu hình database. Việc trộn lẫn Kunrei (vd: Toukyou) và Hepburn (vd: Tōkyō/Tokyo) trong cùng một dự án là lỗi nghiêm trọng gây mất nhất quán dữ liệu.
2. Tại Sao “Dịch Phiên Âm” Lại Quan Trọng Đến Vậy Trong Năm 2026?
Nhiều người lầm tưởng phiên âm chỉ dành cho người mới học. Thực tế năm 2026, nó là “xương sống” của nhiều ngành công nghệ cao:
2.1. Tối Ưu Hóa SEO Đa Ngôn Ngôn (Multilingual SEO) & Internationalization (i18n)
Có thể bạn quan tâm: Hướng Dẫn Toàn Diện Dịch Tiếng Nhật Katakana: Kỹ Thuật, Công Cụ & Xu Hướng Năm 2026
- URL Slug: Google khuyến nghị URL nên đọc được bởi con người.
domain.com/san-pham/tokyo-ekitốt hơndomain.com/san-pham/東京駅hoặcdomain.com/san-pham/%E6%9D%B1%E4%BA%AC%E9%A7%85. - Hreflang & Sitemap: Các thẻ
hreflang="ja-Latn"(Tiếng Nhật viết bằng chữ La-tinh) bắt buộc có phiên âm chuẩn để Google hiểu nội dung trùng lặp hay bản địa hóa. - Voice Search (Tìm kiếm bằng giọng nói): Người dùng nói “Tokyo Eki” thay vì gõ Kanji. Dữ liệu phiên âm chuẩn giúp NLP (Xử lý ngôn ngữ tự nhiên) khớp truy vấn giọng nói với nội dung Kanji.
2.2. Huấn Luyện & Fine-tuning Mô Hình LLM (Large Language Models)
Năm 2026, các mô hình như GPT-5, Gemini 2.0, Llama 3, hoặc các mô hình tiếng Nhật chuyên biệt (như Japanese StableLM, PLaMo) đều yêu cầu dữ liệu huấn luyện có alignment (căn chỉnh) giữa Kanji/Kana và Romaji/Phiên âm IPA.
- Tokenizer: Các tokenizer (như SentencePiece, MeCab + NEologd) xử lý văn bản Nhật hiệu quả nhất khi có layer phiên âm hỗ trợ tách từ (word segmentation) cho từ mới (neologism), tên riêng, từ mượn (Gairaigo).
2.3. Hệ Thống Nhận Diện Tự Động (OCR/ASR) & Điện Toán Đám Mây
- OCR (Nhận dạng chữ): Chuyển ảnh bảng hiệu, hóa đơn, hợp đồng (Kanji) -> Text có thể tìm kiếm (Romaji/Index).
- ASR (Nhận dạng giọng nói – Speech-to-Text): Output thô thường là Kana/Romaji. Cần mô hình Inverse Text Normalization (ITN) để chuyển Romaji -> Kanji chính xác (ví dụ: phân biệt hashi はし là “cây đũa” hay “cầu” qua ngữ cảnh, nhưng phiên âm input đều là hashi).
2.4. Quản Trị Dữ Liệu Master Data (MDM) & CRM
Trong doanh nghiệp đa quốc gia (năm 2026), dữ liệu khách hàng, nhân viên, nhà cung cấp Nhật Bản phải lưu trữ song song: Kanji (Pháp lý), Kana (Phát âm nội bộ), Romaji (Hệ thống quốc tế/Email/CRM/Salesforce). Sai sót ở cột Romaji dẫn đến sai lệch gửi mail, in thẻ, báo cáo thuế.
3. Top Công Cụ & API Dịch Tiếng Nhật Phiên Âm Hiệu Quả Nhất Năm 2026
Thay vì nhập tay (manual) – chậm và dễ sai – năm 2026 quy trình chuyên nghiệp dùng API, Script tự động hóa hoặc phần mềm chuyên dụng.
3.1. API & Thư Viện Lập Trình (Dành cho Developer/Data Engineer)
| Công cụ/Thư viện | Ngôn ngữ | Ưu điểm năm 2026 | Link tham khảo (Generic) |
|---|---|---|---|
| pykakasi | Python | Chuẩn mực Open Source. Hỗ trợ đầy đủ Hepburn, Kunrei, Passport. Xử lý tốt Kanji -> Kana -> Romaji. Tích hợp sẵn MeCab/UniDic để tách từ chính xác. | pip install pykakasi |
| Wanakana | JavaScript/TypeScript | King của Frontend. Chuyển đổi real-time Hiragana <-> Katakana <-> Romaji (Hepburn/Kunrei). Nhẹ, không dependency, hỗ trợ React/Vue/Svelte input component. | npm install wanakana |
| Kuromoji.js / Kuromoji (Java) | JS / Java | Tokenizer (tách từ) + Phiên âm. Bắt buộc cho tìm kiếm full-text (Elasticsearch/OpenSearch) tiếng Nhật. Xử lý từ mới, tên riêng tốt nhờ dict NEologd. | Maven Central / NPM |
| MeCab + UniDic / NEologd | C++/Python/Node | Engine tách từ mạnh nhất. Kết hợp pykakasi hoặc script tự viết để ra Romaji theo ngữ cảnh (disambiguation). |
GitHub (taku910/mecab) |
| Google Cloud Translation API / Transliteration API | REST/gRPC | Enterprise grade. Hỗ trợ ja-Latn (Japanese in Latin script). Độ chính xác cao cho tên riêng, địa danh. Có SLA, phù hợp Production lớn. |
Google Cloud Console |
| ICU4X / ICU (International Components for Unicode) | Rust/C++/JS/Python | Thư viện cốt lõi của Unicode Consortium. Chuẩn hóa (NFKC), Transliteration rule-based (CLDR rules). Dùng cho hệ thống core banking, OS. | icu4x / icu |
3.2. Công Cụ Online/UI (Dành cho Content Manager, Marketer, Dịch Viên)
Có thể bạn quan tâm: Hướng Dẫn Sử Dụng Google Dịch Tiếng Nhật 2026: Tính Năng Mới, Mẹo Tối Ưu & So Sánh Chi Tiết
- RomajiDesu / Jisho.org (Cập nhật UI 2026): Tra từ điển kèm phiên âm Hepburn có dấu thanh (Pitch accent notation) và audio. Phù hợp check nhanh từ đơn.
- MojiNavi / Kakasi Web UI: Dán đoạn văn dài (hàng chục ngàn ký tự) -> Xuất file CSV/Excel 3 cột: Kanji | Kana | Romaji. Hỗ trợ batch processing.
- Notion AI / Google Docs “Translate to Romaji” Add-on (Mới 2025-2026): Tích hợp AI để phiên âm theo ngữ cảnh (context-aware). Ví dụ: “今日” -> Kyō (hôm nay) chứ không phải Konnichi (ngày hôm nay – ít dùng). Đây là bước tiến lớn so với rule-based cũ.
- Excel/Google Sheets Add-in (Kutools, Power Tools): Hàm tùy chỉnh
=ROMANJI(A1)kéo thả hàng ngàn dòng dữ liệu master data.
3.3. Workflow Tự Động Hóa Đề Xuất Năm 2026 (No-code/Low-code)
Make (Integromat) / n8n / Zapier kết nối:
Google Form/Sheet (Input Kanji) -> HTTP Request (Google Transliterate API / Custom Python Function on Cloud Run) -> Google Sheet/Database (Output Kanji, Kana, Romaji, IPA).
4. Kỹ Thuật Chuyên Sâu: Xử Lý Các “Cái Bẫy” Khó Nhất Năm 2026
Dịch phiên âm không phải map 1-1 ký tự. Năm 2026, chất lượng dịch được đo lường bằng cách xử lý tốt 5 vấn đề sau:
4.1. Vấn Đề Long Âm (Long Vowels) & Dấu Thanh (Pitch Accent)
- Quy tắc Hepburn Modified (Chuẩn Passport/ISO 3602):
おう(ou) ->ō(hoặcohtrong passport cũ, nhưng 2026 khuyến nghịōcho dữ liệu máy).えい(ei) ->ē(ví dụ: 先生 -> sensei nhưng 衛星 -> eisei -> ēsei? Không, eisei đọc là ēsei nhưng viết Hepburn thường giữ ei hoặc ē. Chuẩn 2026: Ghiēcho chính xác âm vị, ghieicho tương thích ASCII.)おお(oo) ->ō(大 -> Ōkii).
- Pitch Accent (Kōtei Akusento): Năm 2026, các từ điển điện tử (như Kotobank, Weblio, Mazii) và TTS (Text-to-Speech) đều xuất kèm số hiệu pitch (vd: hashi 0 vs hashi 1). Nếu làm dữ liệu TTS, bắt buộc xuất kèm pitch pattern.
4.2. Sokuon (促音 – Chữ “っ” nhỏ) & Hatsuon (撥音 – “ん”)
- Sokuon: Ghi đôi phụ âm sau nó.
っと->tto,っぷ->ppu,っか->kka.- Lỗi thường gặp: Ghi
xtuhoặcltu(cách gõ IME) -> Tuyệt đối sai khi xuất dữ liệu ra ngoài.
- Lỗi thường gặp: Ghi
- Hatsuon (ん):
- Trước
b, p, m-> ghim(Hepburn chuẩn):しんぶん-> shinmbun (Newspaper),てんぷら-> tempura. - Trước nguyên âm hoặc
y-> ghin'(có dấu nháy đơn) để tách âm tiết:かんい-> kan’i (Đơn giản),さんよう-> san’yō (Sanyo). - Các trường hợp khác ->
n.
- Trước
4.3. Từ Mượn (Gairaigo – 外来語) & Tên Riêng (Jinmei/Chimei) – “Cái Chết Của Rule-based”
Đây là nơi AI/LLM năm 2026 tỏa sáng so với thuật toán quy tắc (rule-based).
- Ví dụ:
ユニバーサルスタジオジャパン-> Yunibāsaru Sutajio Japan (Không phải Yunibaasaru…). - Tên địa danh cố định:
大阪-> Ōsaka,神戸-> Kōbe,北海道-> Hokkaidō. - Tên người:
佐藤-> Satō,斎藤-> Saitō (Khác Saitou – Kunrei). - Giải pháp 2026: Sử dụng Dictionary-based approach (MeCab/NEologd + Custom User Dict) cho từ phổ biến + LLM Few-shot prompting cho tên riêng hiếm, tên thương hiệu mới, từ lóng (slang) năm 2026 (vd: Taiipa – Time Performance, Zutto-tomo – Zutto tomodachi).
4.4. Okurigana (送り仮名) & Động Từ/Tính Từ
Phiên âm phải phản ánh đúng cách biến hóa.
- 食べます (tabemasu) vs 食べる (taberu) vs 食べない (tabenai).
- Tool tốt phải tách được Word Stem và Inflection để không ghi sai (vd: ghi tabe-masu thay vì tabemasu là sai chuẩn Hepburn).
4.5. Kyūjitai (舊字體 – Chữ Cũ) & Variant Characters (Itaiji – 異體字)
Năm 2026, dữ liệu lịch sử, gia phả, văn bản pháp lý cũ vẫn đầy ắp Kyūjitai.
澤(Kyūjitai) =沢(Shinjitai) -> Sawa.渡邊=渡辺-> Watanabe.- Yêu cầu: Hệ thống OCR/Phiên âm năm 2026 phải có Character Normalization Layer (Unicode NFKC + IVS/Ideographic Variation Sequences handling) trước khi đưa vào Engine phiên âm.
5. Quy Trình Chuẩn “Dịch Tiếng Nhật Phiên Âm Chuyên Nghiệp” Năm 2026
Có thể bạn quan tâm: Dịch Tiếng Nhật Chuẩn Online 2026: Hướng Dẫn Chọn Đơn Vị Uy Tín, Bảng Giá Mới Nhất & Quy Trình Chuẩn Quốc Tế
Để交付 (deliver) sản phẩm đạt chuẩn xuất bản, SEO, hoặc dữ liệu AI, hãy tuân thủ quy trình 6 bước:
Bước 1: Chuẩn Hóa Input (Pre-processing)
- Loại bỏ ký tự điều khiển, zero-width space.
- Unicode Normalization: Áp dụng NFKC (Compatibility Composition) để gộp các ký tự tổ hợp (combining marks), chuyển Half-width Katakana -> Full-width, chuyển Kyūjitai phổ biến -> Shinjitai (tùy chính sách dự án).
- Tách đoạn (Segmentation) theo câu/đoạn văn để giữ ngữ cảnh cho LLM.
Bước 2: Tách Từ & Gán Nhãn Loại Từ (Tokenization & POS Tagging)
- Dùng MeCab (UniDic/NEologd) hoặc SudachiPy (chế độ A/B/C).
- Output: Mảng token
Surface, Reading (Kana), BaseForm, POS.
Bước 3: Chuyển Đổi Kana -> Romaji (Core Transliteration)
- Áp dụng rule Hepburn Modified (có dấu
ō, ūcho long âm,n'cho táchん). - Logic đặc biệt:
- Phân biệt 助詞 (Particle):
は(Topic) -> wa,へ(Direction) -> e,を(Object) -> o (hoặc wo tuỳ style guide). - Xử lý Sokuon/Hatsuon như mục 4.2.
- Phân biệt 助詞 (Particle):
Bước 4: Post-Processing & Contextual Correction (Lớp AI/LLM – Mới 2026)
- Chạy qua mô hình LLM (fine-tuned cho Japanese Romanization) để sửa:
- Tên riêng, thương hiệu, từ lóng, từ mới năm 2026.
- Sửa long âm
ei/ou->ē/ōnếu Style Guide yêu cầu. - Gán Pitch Accent number (nếu cần cho TTS).
Bước 5: Quality Assurance (QA) Tự Động & Thủ Công
- Auto-check: Regex kiểm tra pattern cấm (vd:
xtu,ltu,nntrước nguyên âm thiếun',mtrướck/g…). - Spot-check: Random 5-10% mẫu so sánh với từ điển chuẩn (Kojien, Daijirin, NHK Accent Dictionary).
- Round-trip Test: Romaji -> Kana (Wanakani) -> Kanji (IME) -> So khớp gốc. Tỷ lệ khớp phải > 99.9%.
Bước 6: Xuất Dữ Liệu & Metadata
- Format: CSV, JSONL, Parquet, TMX (Translation Memory eXchange).
- Schema bắt buộc:
source_text (Kanji/Kana),reading_kana,romaji_hepburn,romaji_ascii,pos_tags,pitch_accent (optional),confidence_score (nếu dùng AI).
6. Bảng Giá Dịch Tiếng Nhật Phiên Âm Tham Khảo Năm 2026 (Việt Nam & Quốc Tế)
Lưu ý: Giá niêm yết tham khảo thị trường Việt Nam năm 2026, đơn vị VNĐ. Giá thực tế tùy volume, độ phức tạp (chuyên ngành y khoa, pháp lý, IT), deadline và yêu cầu QA.
Có thể bạn quan tâm: Dịch Tiếng Nhật Chính Xác Năm 2026: Tiêu Chí, Quy Trình, Công Cụ AI & Top Đơn Vị Uy Tín Nhất
| Loại hình dịch vụ | Đơn vị tính | Mức giá tham khảo (VNĐ) | Ghi chú năm 2026 |
|---|---|---|---|
| Phiên âm thủ công (Human) – Văn bản thông thường | 1.000 ký tự Kanji (khoảng 400-500 từ) | 80.000 – 150.000 | Dịch viên có N2/N1, check ngữ cảnh, tên riêng. |
| Phiên âm thủ công – Chuyên ngành (Y, Pháp lý, Kỹ thuật, Subtitle) | 1.000 ký tự Kanji | 150.000 – 300.000 | Yêu cầu termbase, tra cứu tên riêng sâu. |
| Phiên âm API/Script (Machine + Rule-based) | 1 triệu ký tự | 500.000 – 2.000.000 | Chạy pykakasi/Google API. Phù hợp data sạch, ít tên riêng. |
| Phiên âm AI/Hybrid (LLM + Human Post-edit – MTPE) | 1.000 ký tự Kanji | 40.000 – 80.000 | Xu hướng mạnh 2026. Nhanh, rẻ, chính xác cao nhờ LLM context-aware. |
| Gán Pitch Accent / IPA | 1.000 từ vựng | 200.000 – 500.000 | Dành cho dự án TTS, từ điển âm thanh. |
| Xây dựng User Dictionary / Termbase | 1 entry (Kanji + Kana + Romaji + POS) | 500 – 1.500 | Dành cho hệ thống Search/OCR/MT nội bộ. |
| Dịch thuật + Phiên âm song song (Bản dịch + Romaji) | 1.000 từ gốc | 300.000 – 600.000 | Output: Col A: Kanji, Col B: Việt, Col C: Romaji. |
Mẹo tiết kiệm chi phí 2026: Nếu dữ liệu > 100k ký tự, hãy yêu cầu báo giá MTPE (Machine Translation Post-Editing cho Phiên âm). Nhà cung cấp chạy model LLM (fine-tuned Japanese Romanization) -> Editor check lỗi tên riêng/số lượng/long âm. Tiết kiệm 50-60% so với làm thuần thủ công.
7. Xu Hướng Công Nghệ “Dịch Phiên Âm” Năm 2026 – 2027
7.1. Context-Aware Romanization (Phiên âm nhận biết ngữ cảnh) bằng LLM
Các model như GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro và các model open-source fine-tuned (như Japanese-Romanization-LoRA trên HuggingFace) đã giải quyết được bài toán Homograph Disambiguation (Phân biệt từ trùng hình).
- Ví dụ:
生trong生ビール(Nama biiru – Bia tươi),先生(Sensei – Thầy),生徒(Seito – Học sinh),生きる(Ikiru – Sống),生まれる(Umareru – Được sinh). - Rule-based cũ thường mặc định Sei hoặc Shou. LLM 2026 đọc hết câu -> xuất đúng Nama, Sensei, Seito, Iki, Uma.
7.2. Zero-Shot Transliteration cho Low-Resource Dialects (Hōgen)
Năm 2026, nghiên cứu tập trung vào phiên âm Kansai-ben, Hakata-ben, Okinawan (Uchinaaguchi). LLM few-shot có thể chuyển なんでやねん -> Nandeyanen (Kansai) thay vì Nande yanen (Hyōjungo), giữ nguyên flavor văn hóa.
7.3. Real-time Romaji Overlay (AR/VR/Meeting)
Trong các cuộc họp Zoom/Teams/Metaverse năm 2026, tính năng Live Caption + Romaji Overlay trở nên phổ biến. Người không biết Kanji/Kana vẫn theo dõi được màn hình chia sẻ (Screen share) tài liệu tiếng Nhật nhờ layer Romaji real-time render bằng WebAssembly (Wasm) chạy Wasm-MeCab/Wanakana ngay trên trình duyệt.
7.4. Unicode CLDR & ICU4X: Chuẩn Hóa Toàn Cầu
Unicode Consortium năm 2025-2026 đẩy mạnh ICU4X (viết bằng Rust, an toàn bộ nhớ, nhanh) thay thế ICU cũ (C++). Các OS (Android 15+, iOS 18+, Windows 12, Linux distros 2026) tích hợp sẵn Transliterator Japanese-Latin/BGN hoặc Japanese-Latin/Hepburn. Dev không cần ship dictionary to, chỉ gọi OS API -> Giảm size app, tăng tốc độ.
8. Checklist Chọn Nhà Cung Cấp / Freelancer Dịch Phiên Âm Năm 2026
Khi thuê ngoài (Outsource), hãy yêu cầu nhà cung cấp cam kết/checklist sau:
- Chuẩn Hepburn Modified (Có dấu long âm
ō/ū+ Dấu táchn'). - Xử lý Particle:
は->wa, へ->e, を->o/wo(Xác nhận Style Guide). - Từ điển tên riêng (Named Entity Dictionary): Có cập nhật năm 2026 không? (Tên tân thần, địa danh mới, thương hiệu hot).
- QA Tự động: Có script check regex lỗi cơ bản (xtu, nn, long âm sai) không?
- Format Output: Hỗ trợ JSON/CSV/Excel có cột
Kanji | Kana | Romaji | POS | Pitch(optional). - Bảo mật dữ liệu (NDA/ISO 27001): Quan trọng nếu dữ liệu là hợp đồng, y tế, tài chính.
- Hỗ trợ Kyūjitai/Itaiji: Có normalize tự động không?
- Sample Test: Yêu cầu làm thử miễn phí 200-500 ký tự phức tạp (có tên người, địa danh, từ mượn, số lượng, particle) trước khi ký hợp đồng.
9. Hướng Dẫn Tự Làm (DIY) Miễn Phí Cho Cá Nhân/Sinh Viên/Doanh Nghiệp Nhỏ
Nếu ngân sách hạn hẹp, bạn có thể tự xây dựng pipeline “Dịch tiếng Nhật phiên âm” miễn phí 100% năm 2026:
Công cụ: Python + Google Colab (Free GPU/CPU) + pykakasi + SudachiPy
Code mẫu chạy ngay trên Colab (Copy -> Paste -> Run):
# 1. Cài đặt (Chạy 1 lần)
!pip install pykakasi sudachipy sudachidict_core -q # 2. Import & Khởi tạo
from pykakasi import kakasi
from sudachipy import tokenizer, dictionary # Tokenizer Sudachi (Mode A: Ngắn nhất, Mode C: Dài nhất - tốt cho từ ghép)
tokenizer_obj = dictionary.Dictionary().create()
mode = tokenizer.Tokenizer.SplitMode.C # Converter pykakasi (Hepburn có dấu long âm)
kakasi_obj = kakasi()
kakasi_obj.setMode('H', 'a') # Hiragana -> Romaji
kakasi_obj.setMode('K', 'a') # Katakana -> Romaji
kakasi_obj.setMode('J', 'a') # Kanji -> Romaji
kakasi_obj.setMode('r', 'Hepburn') # Chuẩn Hepburn
kakasi_obj.setMode('s', True) # Tách từ bằng khoảng trắng
kakasi_obj.setMode('C', True) # Viết hoa đầu câu
converter = kakasi_obj.getConverter() # 3. Hàm xử lý chính
def japanese_to_romaji_pipeline(text): # Bước 1: Tách từ bằng Sudachi (Chuẩn hóa từ ghép, tên riêng) tokens = tokenizer_obj.tokenize(text, mode) # Ghép lại reading form (Kana) đã được tách từ chuẩn # reading_form() trả về Katakana, chuyển sang Hiragana cho pykakasi dễ xử lý long âm kana_text = "".join(t.reading_form() for t in tokens) # Bước 2: Chuyển Kana -> Romaji Hepburn bằng pykakasi # pykakasi xử lý tốt long âm (ou->ō), sokuon, hatsuon (n') romaji = converter.do(kana_text) return romaji, kana_text # 4. Test
samples = "東京駅に行きます。", # Cơ bản "大阪府堺市の渡辺さん", # Tên địa danh, tên người (Watanabe) "新聞を読んでいます。", # Hatsuon (shinbun -> shimbun) "ユニバーサル・スタジオ・ジャパン", # Gairaigo Katakana "頑張ってね!", # Sokuon (gambatte) "先生、おはようございます。", # Particle wa (ha->wa), long âm ohayou for s in samples: romaji, kana = japanese_to_romaji_pipeline(s) print(f"Input: {s}") print(f"Kana : {kana}") print(f"Romaji: {romaji}") print("-" 40)
Kết quả output chuẩn 2026:
Input: 東京駅に行きます。
Kana : トウキョウエキニイキマス
Romaji: Tōkyō Eki Ni Ikimasu. Input: 大阪府堺市の渡辺さん
Kana : オオサカフサカイシノワタナベサン
Romaji: Ōsaka Fu Sakai Shi No Watanabe San Input: 新聞を読んでいます。
Kana : シンブンヲヨンデイマス
Romaji: Shinbun O Yondeimasu. # Lưu ý: n trước b -> m (Hepburn chuẩn) Input: ユニバーサル・スタジオ・ジャパン
Kana : ユニバーサル・スタジオ・ジャパン
Romaji: Yunibāsaru Sutajio Japan Input: 頑張ってね!
Kana : ガンバッテネ
Romaji: Ganbatte Ne! Input: 先生、おはようございます。
Kana : センセイ、オハヨウゴザイマス
Romaji: Sensei, Ohayō Gozaimasu. # ha->wa (particle), ou->ō
Lưu ý: Code trên dùng SplitMode.C (tách từ dài nhất) tốt cho từ ghép. Nếu cần tách từ ngắn (cho search index), đổi sang SplitMode.A. Để thêm Pitch Accent, cần tích hợp thêm thư viện japanese-phonemizer hoặc gọi API có sẵn.
10. Kết Luận: “Dịch Tiếng Nhật Phiên Âm” Năm 2026 – Từ Hỗ Trợ Trở Thành Cốt Lõi Dữ Liệu
Năm 2026, dịch tiếng Nhật phiên âm không còn là công việc “vệ sinh” dữ liệu thủ công tốn kém. Nó là một module kỹ thuật bắt buộc (mandatory component) trong kiến trúc hệ thống đa ngôn ngữ, AI, SEO và trải nghiệm người dùng (UX).
- Đối với Doanh nghiệp: Đầu tư xây dựng Termbase (Cơ sở thuật ngữ) song ngữ Kanji-Romaji và pipeline MTPE (AI + Human) là chiến lược ROI cao nhất. Đừng để team content gõ tay Romaji vào Excel.
- Đối với Developer: Hãy master SudachiPy + pykakasi (hoặc
wanakanacho frontend) và tích hợp LLM Few-shot cho lớp xử lý ngoại lệ (Edge cases). Đừng viết regex tự xử lý long âm/sokuon – dễ sai và khó maintain. - Đối với Dịch viên/Content Creator: Nâng cấp kỹ năng từ “gõ Romaji” sang “QA Romaji” (Kiểm chứng chất lượng phiên âm), “Quản trị Termbase”, “Prompt Engineering cho LLM phiên âm”. Giá trị của bạn nằm ở sự chính xác 100% tên riêng, ngữ cảnh và tuân thủ Style Guide.
Hãy bắt đầu áp dụng các chuẩn mực Hepburn Modified, công cụ tự động hóa hiện đại và tư duy dữ liệu (Data-centric) ngay hôm nay để không bị tụt hậu trong kỷ nguyên AI và toàn cầu hóa dữ liệu năm 2026.