Trong bối cảnh giao lưu văn hóa, kinh tế và du lịch giữa Việt Nam và Nhật Bản ngày càng sôi động tại năm 2026, nhu cầu dịch tiếng Nhật Romaji không chỉ dừng lại ở việc chuyển đổi chữ cái mà còn mở rộng sang xử lý dữ liệu, lập trình NLP, tạo phụ đề video, và hỗ trợ học tập ngôn ngữ. Romaji (ローマ字) – hệ thống viết tiếng Nhật bằng bảng chữ cái La-tinh – đóng vai trò là “cầu nối” quan trọng nhất giữa người không biết Kana/Kanji và ngôn ngữ Nhật. Bài viết này cung cấp cái nhìn sâu sắc, cập nhật nhất về định nghĩa, công cụ, kỹ thuật xử lý, xu hướng AI năm 2026 và các lỗi thường gặp để bạn làm chủ việc chuyển đổi và dịch thuật qua trung gian Romaji một cách chuyên nghiệp.
1. Cơ Chữ Về Romaji: Không Phải Là “Tiếng Nhật”, Là “Hệ Thống Viết”
Trước khi đi vào sâu về dịch thuật, năm 2026 chúng ta cần thiết lập lại tư duy đúng đắn: Romaji không phải là một phương ngữ hay một phiên bản đơn giản hóa của tiếng Nhật. Nó là một hệ thống phiên âm (romanization system). Việc hiểu rõ bản chất này quyết định thành bại của công việc dịch.
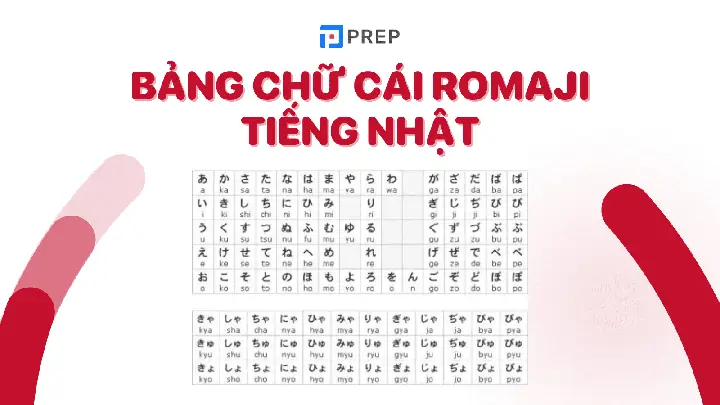
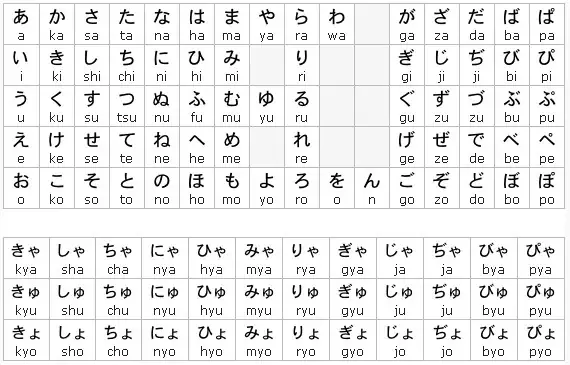
1.1. Ba Hệ Thống Chính Đang Song Song Tồn Tại
Năm 2026, ba hệ thống sau vẫn là tiêu chuẩn vàng, mỗi loại phục vụ mục đích khác nhau:
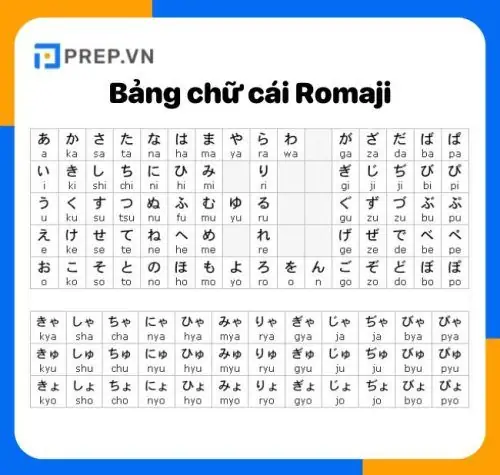
- Hepburn-shiki (式 – Hebon-shiki): Hệ thống phổ biến nhất quốc tế, được dùng cho hộ chiếu, biển báo đường bộ, tên địa danh, từ điển học tiếng Nhật cho người nước ngoài.
- Đặc điểm: Dựa trên phát âm tiếng Anh (sh, ch, ts, y, j, w). Ví dụ: し = shi, ち = chi, つ = tsu, ふ = fu.
- Kunrei-shiki (訓令式 – Kunrei-shiki): Hệ thống chính thức của chính phủ Nhật Bản (theo Chỉ lệnh nội các), được dạy trong trường học Nhật Bản cho trẻ em.
- Đặc điểm: Logic ngữ âm học nội tại, hệ thống hóa chặt chẽ (si, ti, tu, hu). Ví dụ: し = si, ち = ti, つ = tu, ふ = hu.
- Nihon-shiki (日本式 – Nippon-shiki): Hệ thống tiền thân của Kunrei, gần giống Kunrei nhưng giữ một số đặc điểm lịch sử (ví dụ: づ = du, ぢ = di thay vì zu, zi).
Lưu ý thực tế 2026: Khi nhận yêu cầu “dịch sang Romaji”, bạn bắt buộc phải xác nhận với khách hàng/hệ thống họ cần hệ thống nào. Mặc định an toàn nhất cho quốc tế là Hepburn (có phân biệt long vowel: ō, ū hoặc ou, uu).
1.2. Các Quy Tắc “Cái Bẫy” Cần Nhớ (Updated 2026)
Dù dùng công cụ tự động hay thủ công, các quy tắc sau là bắt buộc để đầu ra chuẩn chỉnh:
- Sokuon (促音 – Chữ つ nhỏ / ッ): Viết đôi phụ âm tiếp theo. Ví dụ: きって (kitte),さっか (sakka). Ngoại lệ:
ch->tch(matcha -> maccha trong Kunrei, nhưng matcha trong Hepburn). - Hatsuon (撥音 – ん / ン):
- Trước
b, m, p: Viết m (shimbun, tempura – Hepburn thường giữ n nhưng tempura là ngoại lệ phổ biến). - Trước nguyên âm hoặc
y: Viết n’ (dấu nháy đơn) để tách âm:ren'ai(恋愛),kin'yuu(金融). - Các trường hợp còn lại: Viết n.
- Trước
- Chōon (長音 – Âm dài):
- Hepburn truyền thống:
ō(dấu mũ),ū. Ví dụ:Tōkyō,Kyūshū. - Hepburn sửa đổi (Passport style):
ou,uu. Ví dụ:Toukyou,Kyuusyuu(Kunrei). - Trend 2026: Dữ liệu máy học (ML data) thường yêu cầu không dấu mũ (ASCII only) ->
Toukyou,Osaka,Senpai. Cần chuẩn hóa theo schema của database.
- Hepburn truyền thống:
- Phân tách từ (Word Segmentation): Tiếng Nhật không có dấu cách. Romaji nên có dấu cách theo đơn vị từ (Bunsetsu) hoặc từ vựng để dễ đọc. Ví dụ:
Watashi wa nihongo o benkyou shimasu.thay vìWatashiwanihongoobenkyoushimasu.
2. Phân Loại Nhu Cầu “Dịch Tiếng Nhật Romaji” Năm 2026
Từ khóa này trên thực tế bao gồm 4 luồng công việc hoàn toàn khác nhau về kỹ thuật và giá trị:
Có thể bạn quan tâm: Top 10 Công Cụ Dịch Tiếng Nhật Qua Hình Ảnh Online Miễn Phí & Trả Phí Tốt Nhất Năm 2026: So Sánh Chi Tiết, Hướng Dẫn Sử Dụng Hiệu Quả
2.1. Chuyển Đổi Ký Tự (Transliteration/Conversion) – Mức độ cơ bản
- Input: Văn bản Kana/Kanji (Hiragana, Katakana, Kanji).
- Output: Chuỗi Romaji.
- Công cụ: Thư viện Python (
pykakasi,romkan,cutlet), API Google Cloud/IBM Watson, trang web online. - Ứng dụng: Tiền xử lý dữ liệu NLP, tạo slug URL, index tìm kiếm Elasticsearch/Meilisearch, nhập liệu bàn phím (IME).
2.2. Dịch Nghĩa Qua Trung Gian Romaji (Translation via Romaji) – Mức độ trung cấp
- Quy trình: Nhật (Kanji/Kana) -> Romaji -> Tiếng Việt (hoặc Anh).
- Đối tượng: Người không biết chữ Nhật nhưng nghe được/đọc được Romaji, hoặc hệ thống MT (Machine Translation) đầu vào chỉ nhận ASCII.
- Thách thức: Mất thông tin Kanji (từ đồng âm), mất ranh giới từ, ngữ pháp phụ thuộc vào trợ từ (wa, ga, o, ni) dễ bị hiểu nhầm nếu tách từ sai.
2.3. Tạo Phụ Đề / Karaoke / Furigana Romaji – Mức độ chuyên nghiệp
- Yêu cầu: Đồng bộ thời gian (timestamp), chia dòng hợp lý, xử lý ruby text (furigana) song song.
- Định dạng:
.srt,.ass,.vtt,.lrc. - Công cụ 2026: Aegisub (cũ), Subtitle Edit (mạnh, miễn phí), WhisperX + alignment, các script Python custom.
2.4. Xử Lý Dữ Liệu Lớng (Big Data/ETL) – Mức độ Kỹ sư
- Xử lý hàng triệu record: Tên sản phẩm Rakuten/Amazon JP, địa chỉ, log chatbot.
- Yêu cầu: Tốc độ, xử lý song song (multiprocessing), xử lý lỗi encoding (Shift-JIS, CP932, UTF-8), fallback khi thư viện fail.
3. Bộ Công Cụ “Chuẩn Mực” Năm 2026: Từ Developer Đến End-User
Thời điểm 2026, sự lựa chọn công cụ phụ thuộc vào vai trò của bạn. Dưới đây là bộ công cụ được cộng đồng dev VN và JP tin dùng nhất hiện nay.
3.1. Dành Cho Lập Trình Viên / Data Engineer (Python Ecosystem)
| Thư viện | Ưu điểm | Nhược điểm | Hệ thống hỗ trợ | Trạng thái 2026 |
|---|---|---|---|---|
pykakasi |
Gold Standard. Hỗ trợ đầy đủ Kanji->Kana->Romaji. Tách từ (wakachi-gaki) tốt nhờ MeCab/Janome. Cập nhật thường xuyên. | Nhanh chậm tùy backend tokenizer. Cài đặt MeCab trên Windows đôi khi khó (khuyên dùng janome backend). |
Hepburn, Kunrei, Passport | Active (Phiên bản 2.x+ hỗ trợ Python 3.10-3.12). |
cutlet |
Wrapper nhẹ cho kuromoji (Java) hoặc mecab. Rất nhanh, API đơn giản katsu.convert("東京"). |
Phụ thuộc Java (JVM) nếu dùng Kuromoji backend -> nặng container Docker. | Hepburn (mặc định), Kunrei | Maintenance mode (Ít update feature mới, ổn định). |
romkan |
Chỉ chuyển Kana <-> Romaji. Không xử lý Kanji. | Không dịch Kanji. Chỉ dùng khi đã có Kana. | Hepburn, Kunrei, Hepburn Passport | Stable. |
jaconv |
Chuyển đổi giữa Hiragana, Katakana, Hankaku/Zenkaku (bán góc/toàn góc), Kana <-> Romaji. | Không tách từ, không đọc Kanji. | Hepburn, Kunrei | Active. Rất tốt cho tiền/hậu xử lý. |
sudachipy / fugashi |
Tokenizer hiện đại, nhanh, từ điển cập nhật (NEologd). Dùng làm backend cho pykakasi. |
Cần cài đặt từ điển riêng (system/core/full). | N/A (Tokenizer) | Top Tier cho NLP production. |
Code Mẫu “Best Practice” 2026 (Python 3.11+):
# pip install pykakasijanome # Dùng Janome backend (pure Python, dễ deploy Docker)
from pykakasi import kakasi def convert_to_hepburn(text: str, spaces: bool = True) -> str: """ Chuyển Kanji/Kana -> Romaji Hepburn có dấu cách từ. Xử lý tốt cho batch processing. """ kks = kakasi() # Cấu hình Hepburn chuẩn (passport=False -> dùng macron ō/ū nếu muốn, # nhưng thực tế 2026 hay set passport=True cho ASCII clean) kks.setMode("H", "a") # Hiragana -> Romaji kks.setMode("K", "a") # Katakana -> Romaji kks.setMode("J", "a") # Kanji -> Romaji kks.setMode("r", "Hepburn") # Chế độ Hepburn kks.setMode("s", not spaces) # Space separation kks.setMode("C", True) # Capitalize đầu câu (tùy chọn) converter = kks.getConverter() return converter.do(text) # Test
print(convert_to_hepburn("今日は良い天気ですね。")) # Output: Kyō wa yoi tenki desu ne. (hoặc Kyou wa yoi tenki desu ne. tùy config passport)
3.2. Dành Cho Người Dùng Thường / Dịch Viên / Content Creator (No-Code)
- Google Translate / DeepL (Web/App):
- Tính năng ẩn: Nhấn biểu tượng “bút chì” hoặc “loa” -> Chọn “Show romanization” (Hiển thị phiên âm). DeepL năm 2026 hỗ trợ hiển thị Romaji song song bản dịch rất tốt.
- Yomiwa / Mazii / Jisho.org (App/Web Tra Từ Điển):
- Mazii (Rất mạnh tại VN): Tra từ -> Xem Romaji, Pitch Accent, Ví dụ. Hỗ trợ quét camera (OCR) -> Ra Romaji tức thì.
- Jisho.org: Chuẩn mực tra từ điển, API mở cho dev.
- RomajiDesu / Japanese.io / 10ten Reader (Web):
- Dán đoạn văn Kanji -> Nhấn “Convert” -> Ra Romaji kèm Furigana, phân tích ngữ pháp. Japanese.io cho import file .txt/.epub -> xuất file bilingual.
- Microsoft IME / Google Japanese Input (IME):
- Gõ Romaji -> Ra Kana/Kanji. Ngược lại: Chọn văn bản ->
Ctrl + Shift + F(hoặc menu) -> “Convert to Romaji” (tùy phiên bản OS 2026).
- Gõ Romaji -> Ra Kana/Kanji. Ngược lại: Chọn văn bản ->
3.3. Dành Cho Hệ Thống AI / ASR / TTS (Speech-to-Text / Text-to-Speech)
Có thể bạn quan tâm: Top 10 Ứng Dụng Dịch Tiếng Nhật Qua Ảnh Tốt Nhất Năm 2026: So Sánh Chi Tiết, Review Thực Tế & Hướng Dẫn Chọn Lựa
- OpenAI Whisper (large-v3 / turbo): Năm 2026, Whisper vẫn là SOTA cho ASR tiếng Nhật. Output mặc định là Kanji/Kana. Cần pipeline:
Whisper -> pykakasi -> Romaji. - WhisperX / faster-whisper: Có Word-level Alignment (căn chỉnh từ). Rất quan trọng để tạo Karaoke Romaji có timestamp chính xác từng từ.
- Coqui TTS / VITS / Style-BERT-VITS2: Sinh tiếng Nhật từ text. Input tốt nhất là Kana/Kanji có dấu nhấn (accent). Nếu chỉ có Romaji, model sẽ đoán pitch accent -> sai tự nhiên. Khuyến nghị: Dùng Romaji chỉ để hiển thị UI, dùng Kana/Kanji để inference TTS.
4. Kỹ Thuật Xử Lý Nâng Cao: Giải Quyết “Nỗi Đau” Của Romaji
4.1. Vấn Đề Đa Âm (Homographs) – Kanji Không Có Độc Âm Duy Nhất
Đây là lý do không thể dịch nghĩa chính xác chỉ từ Romaji.
- Ví dụ:
hashi= 橋 (cây cầu) | 箸 (đôi đũa) | 端 (cuối/đầu). - Giải pháp 2026:
- Context-aware Tokenizer: Sử dụng
SudachiPymodeA(Short unit) hoặcC(Long unit) kết hợp từ điển NEologd. - Disambiguation Model: Fine-tune BERT-base-japanese (như
cl-tohoku/bert-base-japanese-v3) trên task Predict Reading (Yomigana prediction). Đây là SOTA hiện nay cho G2P (Grapheme-to-Phoneme). - Rule-based Fallback: Từ điển ưu tiên tần suất (Frequency dictionary) như
unidichoặcIPADIC.
- Context-aware Tokenizer: Sử dụng
4.2. Xử Lý Tên Riêng (Named Entities) – “Cái Chết” Của Mọi Hệ Thống
Tên người, tên địa, tên công ty thường đọc bất quy tắc (Nanori – 呼び名).
- Ví dụ:
田中thường làTanaka, nhưng có người đọcNakata.東郷đọcTōgōnhưng東riêng làHigashi/Azuma. - Chiến lược 2026:
- Dictionary Lookup: Kiểm tra
JMnedict.xml(từ điển tên riêng) -> Cover ~90% phổ biến. - Statistical Guessing: Dùng model
kanji-reading-prediction(GitHub:pfnet/kanji-reading-predictionhoặc các fork 2025/2026). - Human-in-the-loop: Với data quan trọng (hộ chiếu, hợp đồng, y tế), bắt buộc confirm thủ công. Không tin AI 100%.
- Dictionary Lookup: Kiểm tra
4.3. Chuẩn Hóa Unicode & Encoding (Nightmare 2026 Vẫn Còn)
- NFKC Normalization: Bắt buộc áp dụng
unicodedata.normalize('NFKC', text)trước khi xử lý. Gộp Half-width Katakana (半角カナ) -> Full-width. Gộp các ký tự tương thích (ハンカク -> ハンカク). - Variation Selectors (IVS): Một số Kanji có biến thể (ví dụ: 﨑 vs 崎). Cần strip VS hoặc giữ lại tùy yêu cầu matching database.
- Surrogate Pairs (Emoji, Kanji hiếm): Python 3 xử lý tốt, nhưng một số thư viện C/C++ cũ (MeCab build cũ) bị crash. Đảm bảo build MeCab/Sudachi với UTF-8 support đầy đủ.
4.4. Tách Từ (Word Segmentation) Cho Romaji Để Dễ Đọc/Dịch
Romaji không dấu cách rất khó đọc. Thuật toán tách từ cho tiếng Nhật (Word Segmentation) áp dụng cho Romaji:
- Sử dụng SudachiPy Mode C (Longest unit) cho từ vựng đơn vị lớn.
- Quy tắc heuristic: Giữ trợ từ (は, が, を, に, で, と, も, の, へ, から, まで…) tách riêng.
- Giữ động từ/tính từ gốc + đuôi biến vị (taberu, tabenai, tabetai -> tách
taberu,tabenai… không táchtaberu).
5. Xu Hướng Công Nghệ 2026: AI Generative & LLM Thay Đổi Game
Năm 2026, việc “dịch tiếng Nhật Romaji” không còn là bài toán rule-based thuần túy. Large Language Models (LLM) đang định nghĩa lại quy trình.
Có thể bạn quan tâm: Top 10 Ứng Dụng Dịch Tiếng Nhật Qua Hình Ảnh Tốt Nhất Năm 2026: So Sánh Chi Tiết, Review Thực Tế & Hướng Dẫn Chọn Lựa
5.1. LLM Làm Nhiệm Vụ G2P (Grapheme-to-Phoneme) & Disambiguation
Thay vì viết regex phức tạp, bạn prompt GPT-4o / Claude 3.5 Sonnet / Gemini 1.5 Pro / Qwen2.5-72B-Instruct (mạnh tiếng Á Châu) / Llama-3.1-70B-Japanese (fine-tune):
Prompt Template 2026:
“`text
Hãy chuyển đoạn văn tiếng Nhật sau sang Romaji Hepburn (Passport style, không dấu mũ, ASCII only).
Yêu cầu:
1. Tách từ hợp lý (word segmentation).
2. Xử lý đúng đọc tên riêng (Nanori) dựa trên ngữ cảnh.
3. Giữ nguyên dấu câu, số liệu, ký hiệu.
4. Output chỉ có Romaji, không giải thích.Input: “東京都千代田区丸の内1丁目で開催されるAIサミット2026に、田中太郎氏と佐藤花子氏が出席します。”
``Toukyou-to Chiyoda-ku Marunouchi 1-choume de kaisai sareru AI Samitto 2026 ni, Tanaka Tarou-shi to Satou Hanako-shi ga shusseki shimasu.`
Output chất lượng cao:
- Ưu điểm: Hiểu ngữ cảnh, đoán đúng tên riêng, xử lý số đếm (1丁目 -> 1-choume), từ mượn (AI Summit -> AI Samitto).
- Nhược điểm: Tốc độ chậm, chi phí token, non-deterministic (cần temperature=0), hallucination hiếm nhưng có.
- Best Practice 2026: Hybrid Pipeline. Dùng
pykakasi/Sudachicho 95% dữ liệu thông thường (nhanh, rẻ, ổn định). Dùng LLM cho 5% case khó (tên riêng lạ, văn bản sáng tạo, lyric, poem, marketing slogan).
5.2. Multimodal OCR -> Romaji (Image/PDF to Romaji)
Năm 2026, pipeline PaddleOCR / Tesseract / Google Document AI / Azure Form Recognizer -> Layout Analysis -> Reading Order -> Text Extraction -> pykakasi/LLM đã hoàn toàn tự động hóa.
- Ứng dụng: Quét menu nhà hàng, hợp đồng giấy, slide thuyết trình -> Xuất file Excel cột A: Kanji, cột B: Romaji, cột C: Việt/Anh.
5.3. TTS Zero-shot & Voice Cloning Yêu Cầu Phoneme Alignment
Các model TTS mới (OpenVoice V2, CosyVoice, Fish Speech, VITS2 fine-tune) cho phép clone giọng nói chỉ từ 5-10s audio. Chúng yêu cầu input là Phoneme/IPA hoặc Kana có Pitch Accent, không phải Romaji thô.
- Quy trình Pro 2026:
Kanji Text->G2P Model (BERT-based)->Kana + Accent Phrase->TTS Engine. - Romaji chỉ dùng để hiển thị cho user cuối (karaoke, học tập), không dùng để feed vào TTS engine.
6. Case Study Thực Chiến: Xây Dựng Pipeline “Dịch Tiếng Nhật Romaji” Cho Sàn TMĐT Cross-border (Năm 2026)
Giả sử bạn là Tech Lead xây dựng hệ thống đồng bộ sản phẩm từ Rakuten/Yahoo Shopping JP sang sàn TMĐT Việt Nam.
Có thể bạn quan tâm: Top 10 Ứng Dụng Dịch Tiếng Nhật Qua Camera Tốt Nhất Năm 2026: So Sánh Chi Tiết, Review Thực Tế & Hướng Dẫn Chọn Mua
6.1. Yêu Cầu
- Input: Title sản phẩm Nhật (Kanji/Kana/Ký hiệu đặc biệt), 500k SKU/ngày.
- Output:
product_name_romaji(dùng cho URL slug, search index, hiển thị cho shipper VN không biết chữ Nhật),product_name_vi(dịch sang Việt). - Latency: < 50ms/item. Throughput: > 1000 items/s.
6.2. Kiến Trúc Hệ Thống (Architecture)
graph LR ARaw Data Kafka Topic --> B{Pre-processing} B --> CNormalize NFKC<br/>Strip Emoji/IVS C --> DFast Path: pykakasi + SudachiPy<br/>(CPU Bound, Multiprocessing) D --> E{Quality Check} E -- High Confidence --> FOutput Romaji + Slugify E -- Low Confidence / Name Entity --> GQueue: LLM Refinement<br/>(Async, Batch 100 items) G --> HHuman Review UI<br/>(Active Learning Loop) H --> F F --> IVector DB / Elasticsearch<br/>PostgreSQL
6.3. Chi Tiết Xử Lý “Fast Path” (Python Optimized)
# worker.py - Chạy trên cluster Kubernetes, scale HPA theo CPU
import unicodedata
from pykakasi import kakasi
from sudachipy import tokenizer, dictionary
import re # Khởi tạo 1 lần (Global variable trong worker process)
TOKENIZER = dictionary.Dictionary().create()
MODE_C = tokenizer.Tokenizer.SplitMode.C
KKS = kakasi()
KKS.setMode("H", "a"); KKS.setMode("K", "a"); KKS.setMode("J", "a")
KKS.setMode("r", "Hepburn"); KKS.setMode("s", True); KKS.setMode("C", False)
CONVERTER = KKS.getConverter() # Regex compile sẵn
RE_SLUG = re.compile(r'^\w\s-')
RE_SPACES = re.compile(r'\s+') def normalize_text(text: str) -> str: # NFKC: Gộp half-width, full-width, compat chars return unicodedata.normalize('NFKC', text) def slugify_romaji(romaji: str) -> str: # Lowercase, bỏ dấu mũ (nếu có), thay space -> hyphen, bỏ ký tự lạ text = romaji.lower() # Loại bỏ macron (ō -> o) nếu passport style ASCII text = text.replace('ō', 'o').replace('ū', 'u').replace('ī', 'i').replace('ē', 'e').replace('ā', 'a') text = RE_SLUG.sub('', text) text = RE_SPACES.sub('-', text.strip()) return text:200 # Giới hạn độ dài URL def process_item(title_jp: str) -> dict: clean = normalize_text(title_jp) # 1. Tokenize Sudachi (Lấy reading form - hiragana reading) # Mode C cho từ dài, chính xác cho tên sản phẩm tokens = TOKENIZER.tokenize(clean, MODE_C) # Ghép reading form (dạng hiragana) để pykakasi chuyển chính xác hơn Kanji khó # Hoặc dùng dictionary form. Reading form an toàn hơn cho G2P. reading_text = "".join(t.reading_form() for t in tokens) # 2. Convert to Romaji # pykakasi nhận Kana rất nhanh và chính xác 100% quy tắc romaji = CONVERTER.do(reading_text) # 3. Post-process romaji = romaji.strip() slug = slugify_romaji(romaji) # 4. Heuristic Quality Score (Đơn giản) # Nếu tỷ lệ ký tự Latinh / tổng ký tự < 0.9 -> có thể còn sót Kanji/Kana # Hoặc nếu có tên riêng nghi ngờ (chứa Katakana dài > 5 ký tự không phải loanword) score = 1.0 if len(re.findall(r'一-龯', clean)) > 0 and len(re.findall(r'一-龯', romaji)) > 0: score = 0.5 # Vẫn còn Kanji -> Fail return { "romaji": romaji, "slug": slug, "quality_score": score, "needs_review": score < 0.95 }
6.4. Xử Lý “Slow Path” Với LLM (Batch Async)
Gửi batch 100 items needs_review=true vào Queue (RabbitMQ/Redis Stream). Worker LLM (GPU node) xử lý:
- Prompt kèm few-shot examples về tên thương hiệu, đơn vị đo lường Nhật (個, 枚, 本, セット).
- Parse JSON output.
- Cập nhật DB. Log case khó -> Giao cho team Content/Vietnamese-native-speaker-reviewer qua Internal Tool (Retool/ToolJet).
6.5. Monitoring & Observability (2026 Standard)
- Metrics:
conversion_latency_p50/p99,llm_fallback_rate,human_review_rate,slug_collision_rate. - Alert: Nếu
llm_fallback_rate> 5% -> Cảnh báo từ điển Sudachi/NEologd cần update hoặc prompt LLM cần tune. - A/B Test: So sánh CTR (Click-through rate) của sản phẩm dùng Romaji slug vs ID số. Năm 2026, SEO đa ngôn ngữ (hreflang) yêu cầu URL có nghĩa (semantic URL) -> Romaji slug là bắt buộc.
7. Ứng Dụng Học Tập & Văn Hóa: Romaji Trong Giáo Dục Năm 2026
7.1. Cho Người Việt Nam Học Tiếng Nhật
- Giai đoạn 1 (0-3 tháng): Romaji là cây gậy phép thuật. Học Hiragana/Katakana song song, nhưng dùng Romaji để ghi âm từ vựng, ngữ pháp, nghe nói (Shadowing).
- Giai đoạn 2 (3-12 tháng): Cai nghiện Romaji. Bắt buộc ẩn Romaji trong Anki/Flashcard. Chỉ nhìn Kanji/Kana -> Nghĩa/Âm thanh.
- Tool hỗ trợ 2026:
- Anki Add-on:
Japanese Support(tự động thêm Reading/Furigana/Romaji vào card). - Migaku / Language Reactor (Extension): Xem Netflix/YouTube -> Bật sub kép Kanji + Romaji + Việt. Click từ -> Tra từ điển -> Xuất Anki.
- Renshuu / Kaishi / Bunpro: App học ngữ pháp/game hóa, cho phép bật/tắt Romaji tuỳ cấp độ.
- Anki Add-on:
7.2. Cho Người Nhật Học Tiếng Việt (Ngược)
- Romaji đóng vai trò trung gian phát âm. Ví dụ: Tiếng Việt “Người” -> Romaji
Nguoi(gầnングオイ– Nguoi) giúp người Nhật hình dung thanh điệu (thanh Huyền) dễ hơn IPA/ŋʷɨəj˨˩/. - Xu hướng 2026: Sách giáo khoa/ứng dụng dạy Tiếng Việt cho người Nhật dùng Chữ Quốc Ngữ (Vietnamese Alphabet) song song với Katakana/Romaji để minh họa âm tiết.
8. Các Sai Lầm “Chết Người” Khi Làm Việc Với Romaji (Lessons Learned)
-
Dùng Romaji làm Key chính trong Database (Primary Key/Unique ID).
- Sai:
WHERE romaji_name = 'tanaka'-> Trùng lặp hàng nghìn người. - Đúng: Dùng
kanji_name+reading_kana+idlàm key. Romaji chỉ làdisplay_columnhoặcsearch_index.
- Sai:
-
Tin cậy tuyệt đối vào
str.lower()hoặcstr.upper()cho tiếng Nhật.- Romaji có dấu mũ (
Ō,Ū) hoặc ký tự đặc biệt. Pythonlower()xử lý Unicode tốt, nhưng một số DB (MySQLutf8mb4_general_cicũ) hoặc hệ thống legacy có thể case-insensitive sai với macron. Chuẩn hóa: Luôn lưu ASCII-folded version (ou, uu) riêng cộtsearch_romaji.
- Romaji có dấu mũ (
-
Quên
n'(dấu nháy) trước nguyên âm/y.renai(恋愛) vsren'ai. Không có dấu nháy -> đọc thànhre-nai(れない – không làm được) thay vìre-nai(れんあい). Năm 2026, các hệ thống TTS/ASR hiện đại bắt buộc có dấu nháy hoặc tách từ rõ ràng để phát âm đúng.
-
Xử lý số đếm (Josuushi – 助数詞) sai khi chuyển Romaji.
1人->hitori(không phảiichi-nin).2階->nikai(không phảini-kai– đọc bình thường cũng được nhưngnikaitự nhiên hơn).3冊->sansatsu.- Giải pháp: Tokenizer (Sudachi/MeCab) output
reading_formđã xử lý sẵn sandhi (liên âm). Luôn convert từreading_form(Kana) sang Romaji, không convert thẳng từsurface(Kanji).
-
Không xử lý “Ruby” / “Furigana” trong HTML/EPUB/PDF input.
- Input:
<ruby>東<rt>とう</rt></ruby><ruby>京<rt>きょう</rt></ruby>. - Nếu strip tag thô ->
東京->Toukyou(OK). - Nhưng nếu input:
<ruby>彼<rt>かれ</rt></ruby>氏(Kare-shi – người yêu) vs<ruby>彼氏<rt>かれし</rt></ruby>(Cũng Kareshi). - Trường hợp xấu:
<ruby>田中<rt>たなか</rt></ruby><ruby>さん<rt>さん</rt></ruby>-> Strip ->田中さん->Tanaka-san. - Best Practice: Dùng
BeautifulSoup/lxmlextractrt(ruby text) nếu có, ưu tiênrtlàm reading source. Nếu không córt, fallback vềsurface-> Tokenizer.
- Input:
9. Tài Nguyên & Cộng Đồng Cập Nhật 2026 (Bookmark Ngay)
9.1. Kho Dữ Liệu & Từ Điển (Mở, Miễn Phí, Cập Nhật)
- JMdict / JMnedict (EDICT): Dữ liệu gốc cho hầu hết từ điển. Phiên bản 2026 có sẵn tại
ftp.edrdg.orghoặc GitHubscriptin/jmdict-simplified(format JSON dễ dùng). - NEologd (mecab-ipadic-NEologd): Từ điển MeCab cập nhật hàng tuần từ Web (từ lóng, tên mới, trend). Bắt buộc cho production NLP.
- SudachiDict (Full/Core/Small): Từ điển cho SudachiPy. Phiên bản
full~400MB, cover tên riêng rất tốt. - KanjiVG / KanjiData: Data stroke order, thành phần, reading cho từng Kanji.
9.2. Thư Viện & Model Nổi Bật GitHub (Stars > 1k, Updated 2025-2026)
pfnet/kanji-reading-prediction(SOTA G2P).WorksApplications/SudachiPy(Tokenizer chính thức).miurahr/romkan(Pure Python Kana<->Romaji).soimort/you-get/yt-dlp(Download video -> extract sub -> convert Romaji).coqui-ai/TTS/facebook/fastspeech2/kan-bayashi/VITS(TTS pipeline).
9.3. Cộng Đồng Hỏi Đáp / Thảo Luận (Tiếng Việt & Quốc Tế)
- Facebook Groups: “Học Tiếng Nhật Tự Học”, “Cộng Đồng Dịch Thuật Việt – Nhật”, “Japanese NLP Vietnam”.
- Reddit:
r/LearnJapanese,r/translator,r/NLP,r/LocalLLaMA(chạy LLM local dịch Nhật). - Zenn.dev / Qiita.com: Nơi kỹ sư Nhật đăng bài technical rất sâu về tokenizer, G2P, TTS (Dùng Google Translate trang web hoặc extension dịch trang).
10. Kết Luận: Lộ Trình Làm Chủ “Dịch Tiếng Nhật Romaji” Năm 2026
Năm 2026, dịch tiếng Nhật Romaji đã vượt ra khỏi khái niệm “gõ chữ La-tinh ra Kana”. Nó là một quy trình kỹ thuật đa tầng:
- Hiểu bản chất: Romaji là biểu diễn, không phải ngôn ngữ. Luôn giữ gốc Kanji/Kana làm nguồn sự thật (Source of Truth).
- Chọn đúng hệ thống: Hepburn (Passport/ASCII) cho quốc tế/web; Kunrei cho giáo dục Nhật; Có dấu mũ (Macron) cho học thuật/ngôn ngữ học.
- Xây dựng Pipeline Hybrid:
Rule-based (Sudachi/pykakasi)làm xương sống (95% throughput) +LLM (Qwen/GPT/Claude)làm não bộ xử lý ngoại lệ/tên riêng/sáng tạo +Human-in-the-looplàm an toàn cho data quan trọng. - Chuẩn hóa dữ liệu: Unicode NFKC, ASCII-folding cho search, tách từ chuẩn, xử lý
n', số đếm, tên riêng. - Áp dụng vào đúng chỗ: URL slug, Search index, Karaoke/Subtitle, Học tập (giai đoạn đầu), OCR pipeline. Không dùng cho TTS input, không dùng cho Primary Key, không dùng cho dịch nghĩa chính xác nếu thiếu ngữ cảnh Kanji.
Với sự bùng nổ của AI Generative và nhu cầu đa ngôn ngữ trong khu vực ASEAN-Nhật năm 2026, người làm chủ được pipeline Kanji -> Kana (Reading) -> Romaji (Standardized) -> Target Language/Application sẽ nắm giữ lợi thế to lớn trong localization, data engineering, edtech và cross-border commerce. Hãy bắt đầu bằng việc setup môi trường pykakasi + SudachiPy hôm nay, chạy thử trên 10.000 sample data thực tế từ Rakuten/NHK, và lặp lại quy trình QA. Chúc bạn xây dựng thành công hệ thống xử lý tiếng Nhật mạnh mẽ nhất!